计算机技术与人工智能基础实验教程 人工智能基础资源与技术
1. 引言
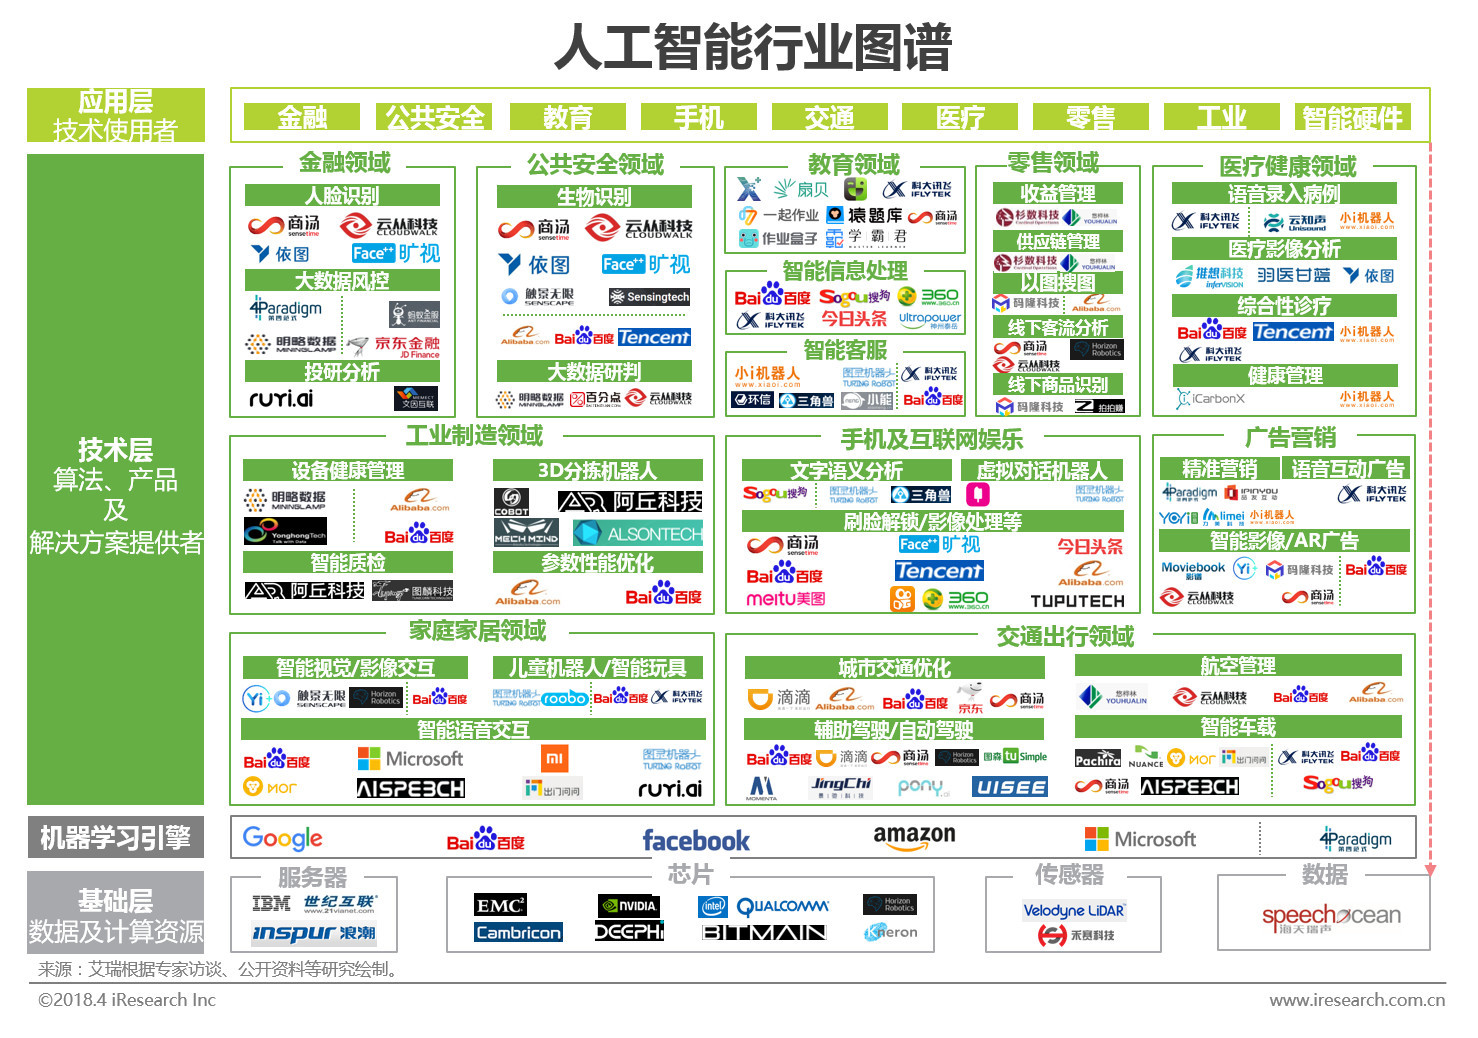
人工智能(Artificial Intelligence, AI)已成为推动新一轮科技革命和产业变革的战略性技术。掌握人工智能的基础资源与技术,是深入理解并应用AI的关键。本教程旨在为计算机技术与人工智能相关专业的学生和爱好者提供一套系统的实验指导,围绕人工智能所需的数据资源、计算资源、算法工具以及核心技术展开,通过理论讲解与实验操作相结合的方式,帮助读者快速建立起AI实验的基本能力。
2. 人工智能基础资源
2.1 数据资源
数据是人工智能的“燃料”。实验过程中,常用的公开数据集包括:
- 图像数据集:MNIST、CIFAR-10/100、ImageNet等,用于图像分类、目标检测等任务。
- 文本数据集:IMDB影评、Reuters新闻、SQuAD问答等,用于自然语言处理任务。
- 语音数据集:LibriSpeech、TIMIT等,用于语音识别与合成。
- 结构化数据集:Iris、Boston Housing、Titanic等,用于传统机器学习实验。
获取数据后,通常需要进行数据清洗、归一化、增强等预处理操作。实验中可使用Python的pandas、NumPy、OpenCV、NLTK等库完成。
2.2 计算资源
深度学习模型训练往往需要强大的算力支持:
- CPU:适用于小规模模型和传统机器学习算法。
- GPU:NVIDIA系列GPU配合CUDA/cuDNN可大幅加速矩阵运算,是深度学习实验的首选。
- TPU:Google专为TensorFlow设计的张量处理单元,可通过Colab免费使用。
- 云平台:AWS、Azure、阿里云等提供弹性GPU实例,适合大规模实验。
实验环境建议:本地安装Anaconda + Jupyter Notebook,或直接使用Google Colab、Kaggle Kernels等在线平台。
2.3 软件与框架资源
- 编程语言:Python是AI实验的主流语言。
- 核心库:NumPy(数值计算)、SciPy(科学计算)、Matplotlib(可视化)、scikit-learn(传统机器学习)。
- 深度学习框架:TensorFlow、PyTorch、Keras、PaddlePaddle。
- 特色工具:OpenCV(计算机视觉)、Hugging Face Transformers(预训练模型)、Gym(强化学习)。
3. 人工智能基础技术
3.1 机器学习基础
机器学习是AI的核心,主要分为监督学习、无监督学习和强化学习。实验中可从线性回归、逻辑回归、决策树、支持向量机(SVM)、K-means聚类等经典算法入手。
实验示例:使用scikit-learn对Iris数据集进行分类,比较不同分类器的准确率。
3.2 深度学习基础
深度学习通过多层神经网络自动提取特征。基础网络包括全连接网络(MLP)、卷积神经网络(CNN)、循环神经网络(RNN)等。
实验示例:使用PyTorch构建一个简单的CNN,在MNIST手写数字数据集上实现分类,观察训练过程中的损失和准确率变化。
3.3 自然语言处理基础
自然语言处理(NLP)关注计算机与人类语言的交互。基础技术包括词袋模型、TF-IDF、词嵌入(Word2Vec、GloVe)以及预训练语言模型(BERT、GPT)。
实验示例:使用Hugging Face Transformers库加载预训练的BERT模型,对IMDB影评进行情感分析。
3.4 计算机视觉基础
计算机视觉旨在让机器“看懂”图像。基础任务包括图像分类、目标检测、图像分割等。传统方法有SIFT、HOG,深度学习方法以CNN为主干。
实验示例:使用OpenCV实现人脸检测(基于Haar级联),或使用预训练的ResNet进行图像分类。
4. 实验教程设计
4.1 实验环境搭建
- 安装Python 3.8+和Anaconda。
- 创建虚拟环境:
conda create -n ai_env python=3.8。 - 安装必要库:
pip install numpy pandas matplotlib scikit-learn tensorflow pytorch opencv-python。
4.2 实验一:数据预处理与可视化
目的:掌握数据加载、清洗、归一化和可视化方法。
步骤:
1. 使用pandas读取CSV数据。
2. 处理缺失值、异常值。
3. 使用Matplotlib绘制特征分布图。
4. 对数据进行标准化或归一化。
4.3 实验二:传统机器学习算法比较
目的:理解不同机器学习算法的适用场景。
步骤:
1. 加载Iris数据集,划分训练集和测试集。
2. 分别使用逻辑回归、SVM、随机森林进行训练。
3. 评估模型准确率、精确率、召回率。
4. 绘制混淆矩阵。
4.4 实验三:卷积神经网络实现手写数字识别
目的:掌握CNN的基本原理和PyTorch实现。
步骤:
1. 加载MNIST数据集,进行归一化。
2. 定义CNN模型(两个卷积层+两个全连接层)。
3. 定义损失函数(交叉熵)和优化器(Adam)。
4. 训练模型并记录损失/准确率曲线。
5. 在测试集上评估模型性能。
4.5 实验四:预训练模型进行情感分析
目的:了解迁移学习与预训练语言模型的使用。
步骤:
1. 使用Hugging Face加载预训练BERT及其分词器。
2. 准备IMDB影评数据集。
3. 对BERT进行微调(或直接使用管道进行推理)。
4. 评估情感分类准确率。
5. 与展望
本教程涵盖了人工智能实验所需的基础资源(数据、计算、软件)和基础技术(机器学习、深度学习、NLP、CV),并给出了四个循序渐进的实验案例。通过这些实验,读者能够快速上手AI实验,理解从数据处理到模型训练的全流程。随着大模型和生成式AI的发展,建议进一步探索分布式训练、模型压缩、多模态学习等前沿方向,不断提升实验能力与创新能力。
注意:实验过程中请遵守数据伦理和版权规定,合理使用计算资源。
如若转载,请注明出处:http://www.mayuhong888.com/product/16.html
更新时间:2026-10-31 06:06:14